 Scribendi Expert Data
定義
基準を設定する
適用・監査が可能で、根拠を明確に説明できる品質基準を策定します。
- 評価ルーブリックの作成:評価項目、尺度、アンカー例
- ゴールドセットの構築とアノテーターのキャリブレーション
- LLM評価者のキャリブレーション:人間の評価とのずれを測定・縮小
- 再利用可能なアノテーションガイドライン:お客様・当社どちらのチームでも活用
サービス
文章の品質を測定可能にする評価ルーブリック。モデルの現在の性能を明らかにする専門家による評価。モデルをさらに進化させる学習データ。
定義
適用・監査が可能で、根拠を明確に説明できる品質基準を策定します。
評価
専門家による評価で、モデルの出力のどこに、なぜ問題があるのかを明らかにします。
構築
専門家が作成した、権利処理済みですぐに学習に使用できるデータを提供します。
活用シーン
最先端のAIモデルを開発するチームでも、そのモデルを基盤にサービスやプロダクトを構築するチームでも、取り組み方に応じて必要なサービスは変わります。しかし、求める品質の水準は変わりません。私たちが特に強みを持つのは、高度な専門性が求められる科学、医学、学術分野の文章です。
RAG、エージェント、直接生成など、どのような形でAPIを利用する場合でも、プロダクトの品質を左右するのは出力の品質です。基盤となるモデルが変わっても、その品質が維持されているかを、専門家が評価します。一般的な最初の取り組み:モデルのアップデートに伴う品質の変化を追跡する、継続的なSxS評価。
最初のステップ評価定義
タスクによってフロンティアAPIと自社モデルを使い分けます。システム全体を評価し、自社で運用するモデルを学習させます。一般的な最初の取り組み:システム全体を評価し、その後、自社で学習するモデル向けのデータを構築。
最初のステップ評価構築
基盤モデルを自社のドメインに合わせてファインチューニングする場合、価値を生み出すのはその適応部分です。ドメインに特化した選好データや校正ペアによって、その程度を高めます。一般的な最初の取り組み:ドメインに合わせてキャリブレーションした評価ルーブリックと、ファインチューニングに使用するゴールドデータの作成
最初のステップ構築評価
学習の全工程を自社で手がける場合、モデルの性能の上限を決めるのはデータです。専門家が作成したゴールドセットが、特に重要なポストトレーニングで、その上限を引き上げます。
最初のステップ構築評価
知見
1997年以来、私たちは学術、科学など、さまざまな専門分野で膨大な量の文章を校正してきました。その経験をもとに、なぜ良い文章が「良い」のかを、モデルが学習できる評価基準として示すことができます。
応募者のうち採用されるのは1%未満。エディターの多くが博士号を取得しています。すべての専門家がトレーニングを受け、当社の基準に沿って品質を統一。さらに、実際の業務すべてで品質評価を行っています。クラウドワーカーに仕事を委託するマーケットプレイスではなく、当社が一貫して品質に責任を持つ専門家チームです。
当社のチームは、文章の良し悪しを評価する手法を研究し、その成果を論文として発表しています。その中には、「Scribendi Score」(EMNLP 2021、他の研究機関でも実装)や、人が修正するのに必要な労力に基づいて、修正ツールの出力を評価する「PEET」(2025)などがあります。お客様のモデルに使用する評価基準を設定するのは、言語品質モデルを実際に開発し、実用化している専門家です。
私たちが扱う言語は英語のみ。その中でも特に、科学・学術・専門分野で英語を母語としない方が書く文章という、難易度の高い領域を得意としています。Scribendiは1997年以来、世界中のお客様のESL(第二言語としての英語)の文章を磨き続けてきました。エダンズは20年にわたり、日本の研究者による英語での論文発表を支援してきました。

1997年以来、150か国以上、33万5,000を超えるお客様にサービスを提供。その中には、1,600を超える学術誌、大学、学術団体も含まれます。こうした実績の背景にあるコーパス、エディター、そして品質管理の仕組みが、私たちの基盤です。
チーム
CTOと主任AIリサーチャーが、すべてのプロジェクトに直接携わります。別のチームへ引き継ぐことはありません。
最高技術責任者(CTO)
AI研究の成果を発表するとともに、当社の本番環境向けLLM、GECモデル、評価手法の実用化を担当。Scribendiに在籍して15年。すべてのプロジェクトで使用されるプラットフォーム「EditorWorks」を構築し、2度の買収を経てテクノロジー部門を率いています。
LinkedInでつながる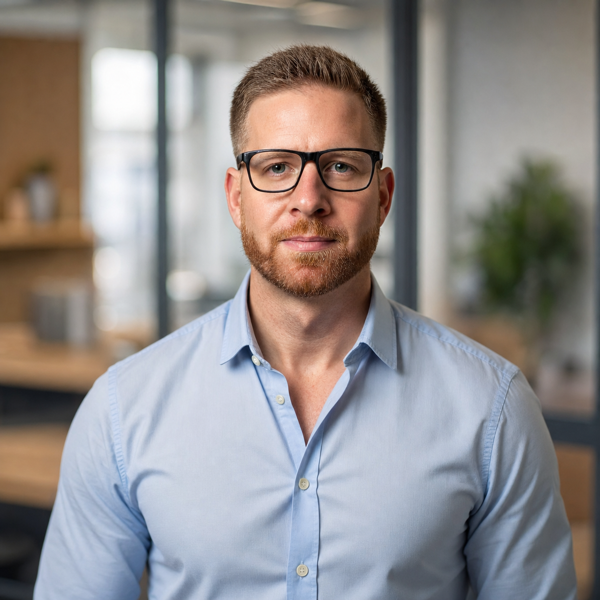
最高技術責任者(CTO)
AI研究の成果を発表するとともに、当社の本番環境向けLLM、GECモデル、評価手法の実用化を担当。Scribendiに在籍して15年。すべてのプロジェクトで使用されるプラットフォーム「EditorWorks」を構築し、2度の買収を経てテクノロジー部門を率いています。
LinkedInでつながるデザインパートナープログラム
2026年、少数のデザインパートナーと協働し、それぞれのニーズに合わせてサービスを形づくっていきます。
2026年中は、初期パートナー向けの特別料金を設定しています。その代わり、事例紹介へのご協力をお願いいたします(必要に応じて匿名での掲載も可能です)。
ご相談ください
お客様が構築しているものについてお聞かせください。スタックに合わせて、成果物、料金、スケジュールを定めたパイロットをご提案いたします。
大量の専門家判断を必要とするプロダクトに、お客様の仕様、ブランド、品質基準に沿った専門家リソースを提供します。
ホワイトラベルのまま提供。まずはNDAから。